自进化智能体研究报告:工具增强推理的零数据演进框架 核心论文 1. *Agent0-VL: Exploring Self-Evolving Agent for Tool-Integrated Vision-Language Reasoning* (arXiv:2511.19900) 2. *Agent0: Unlea…
自进化智能体研究报告:工具增强推理的零数据演进框架
核心论文
1. *Agent0-VL: Exploring Self-Evolving Agent for Tool-Integrated Vision-Language Reasoning* (arXiv:2511.19900)
2. *Agent0: Unleashing Self-Evolving Agents from Zero Data via Tool-Integrated Reasoning* (arXiv:2511.16043)
一、研究背景与挑战
#### 1.1 现有瓶颈
- 数据依赖性:传统智能体依赖人类标注数据(如RLHF),成本高且受限于人类知识边界。
- 能力天花板:模型自进化受限于固有知识,难以生成超越自身能力的复杂任务。
- 单轮交互局限:现有框架多为单轮交互,无法处理多步骤、工具依赖的动态任务。
#### 1.2 关键问题
如何实现零外部数据下的智能体持续进化?
如何突破模型固有能力限制,生成高难度课程?
如何整合工具使用与多轮推理以解决复杂任务?
二、技术框架与创新
#### 2.1 Agent0通用框架(零数据自进化)
双智能体共进化机制:
核心创新:
\[R_{\text{tool}} = \gamma \cdot \min(N_{\text{tool}}, C)\]
其中 \(N_{\text{tool}}\) 为工具调用次数,激励课程智能体生成需工具解决的复杂任务。
保留自一致性
\($\hat{p} \in [0.3, 0.8]$\) 的任务,确保难度适中。
- 多轮交互支持:支持上下文依赖的对话式任务(如代码调试)。
#### 2.2 Agent0-VL视觉扩展(多模态自进化)
双角色统一架构:
自进化推理循环(SERC):
1.
内循环:求解器生成轨迹 → 验证器工具验证 → 置信度低于阈值时触发修复。
2.
外循环:GRPO基于过程奖励更新策略,对齐推理与评估分布。
工具验证机制:
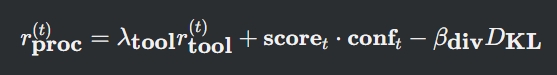
\[g_t = \sigma(\kappa (\tau_c - \text{conf}_t))\]
当置信度
\($\text{conf}_t < \tau_c$\) 时激活修复,避免错误传播。
三、实验验证与性能
#### 3.1 Agent0通用性能(数学与通用推理)
#### 3.2 Agent0-VL视觉性能
消融实验结论:
- 移除工具使用 → 性能下降6.5%(Agent0)
- 移除自我修复 → 性能下降2.5%(Agent0-VL)
- 移除SERC循环 → 性能下降8.7%(Agent0-VL)
---
四、应用场景与案例
#### 4.1 典型案例
初始错误:误判盲象限 → 验证器工具检测 → 修复逻辑 → 正确计算航行距离(图8)。
迭代1:基础代数 → 迭代3:约束优化问题(图5)。
#### 4.2 落地场景
五、局限性与未来方向
#### 5.1 当前局限
- 计算开销:多轮交互与工具调用增加推理延迟(Agent0-VL单任务耗时+30%)。
- 工具依赖:外部工具的可靠性影响系统稳定性(如沙箱执行错误)。
- 泛化边界:跨领域任务迁移需进一步验证(如医学影像→金融图表)。
#### 5.2 未来方向
1.
轻量化工具集成:开发专用工具芯片降低延迟。
2.
跨模态课程生成:扩展Agent0至音频、视频多模态任务。
3.
人类偏好对齐:引入稀疏人类反馈优化课程质量。
六、结论
Agent0与Agent0-VL通过
工具增强推理与
零数据自进化,突破了传统智能体的数据依赖和能力天花板:
- Agent0:双智能体共进化实现通用任务能力跃升(数学+18%,通用+24%)。
- Agent0-VL:视觉-语言工具验证与自我修复解决多模态推理瓶颈(平均+12.5%)。
核心价值:为构建无需人类干预的自主进化智能体提供了可复现的技术路径,推动AI向“自我完善”范式演进。
---
附录:
- 代码库:https://github.com/aiming-lab/Agent0
- 实验配置:8×NVIDIA H200,GRPO组大小 \(G=8\),置信阈值 \(\tau_c=0.7\)。
