
ReContext 原理解析与使用教程
今之 LLM,动辄支持 128K 乃至百万 token 之上下文。然则上下文愈长,模型于生成时能否反复聚焦于那寥寥数行真正相关的证据,方是成败关键。研究者发现一现象,可谓触目惊心:
目录
- 目录
- 一、缘起:长上下文之困
- 二、核心思想:以模型之眼,照见自身所重
- 三、整体架构一览
- 四、四步算法详解
- 步骤一:注意力读取(Attention Readout)
- 步骤二:证据物化(Evidence Materialization)
- 步骤三:递归重放(Recursive Replay)
- 步骤四:最终生成(Final Generation)
- 五、代码架构:模块与数据流
- 5.1 模型改造:注入干预接口
- 5.2 生成逻辑:CustomGenerationMixin
- 5.3 Prompt 边界检测
- 5.4 完整数据流
- 六、RescaleConfig 配置详解
- 6.1 完整参数表
- 6.2 三大 backbone 的默认配置
- 6.3 命令行覆盖
- 七、数据集与评估体系
- 7.1 数据集一览
- 7.2 数据文件结构
- 7.3 评估指标
- 7.4 主结果
- 八、基线方法对比
- 九、使用教程:从零复现
- 9.1 环境准备
- 9.2 数据准备
- 9.3 模型准备
- 9.4 运行单次评测
- 9.5 运行复现脚本
- 9.6 结果文件
- 9.7 跑基线对比
- 十、实战示例与调参指南
- 10.1 调参心法
- 10.2 常见问题排查
- 10.3 调试:查看选了哪些句子
- 十一、设计哲学与局限
- 11.1 设计哲学
- 11.2 局限与展望
- 附录:术语表
ReContext: Recursive Evidence Replay as an LLM Harness for Long-Context Reasoning
Princeton Language and Intelligence (PLI) · MIT License · 2026
目录
- 一、缘起:长上下文之困
- 二、核心思想:以模型之眼,照见自身所重
- 三、整体架构一览
- 四、四步算法详解
- 五、代码架构:模块与数据流
- 六、RescaleConfig 配置详解
- 七、数据集与评估体系
- 八、基线方法对比
- 九、使用教程:从零复现
- 十、实战示例与调参指南
- 十一、设计哲学与局限
- 附录:术语表
一、缘起:长上下文之困
长上下文推理之难,非唯"塞得下",更在"看得准"。
今之 LLM,动辄支持 128K 乃至百万 token 之上下文。然则上下文愈长,模型于生成时能否反复聚焦于那寥寥数行真正相关的证据,方是成败关键。研究者发现一现象,可谓触目惊心:
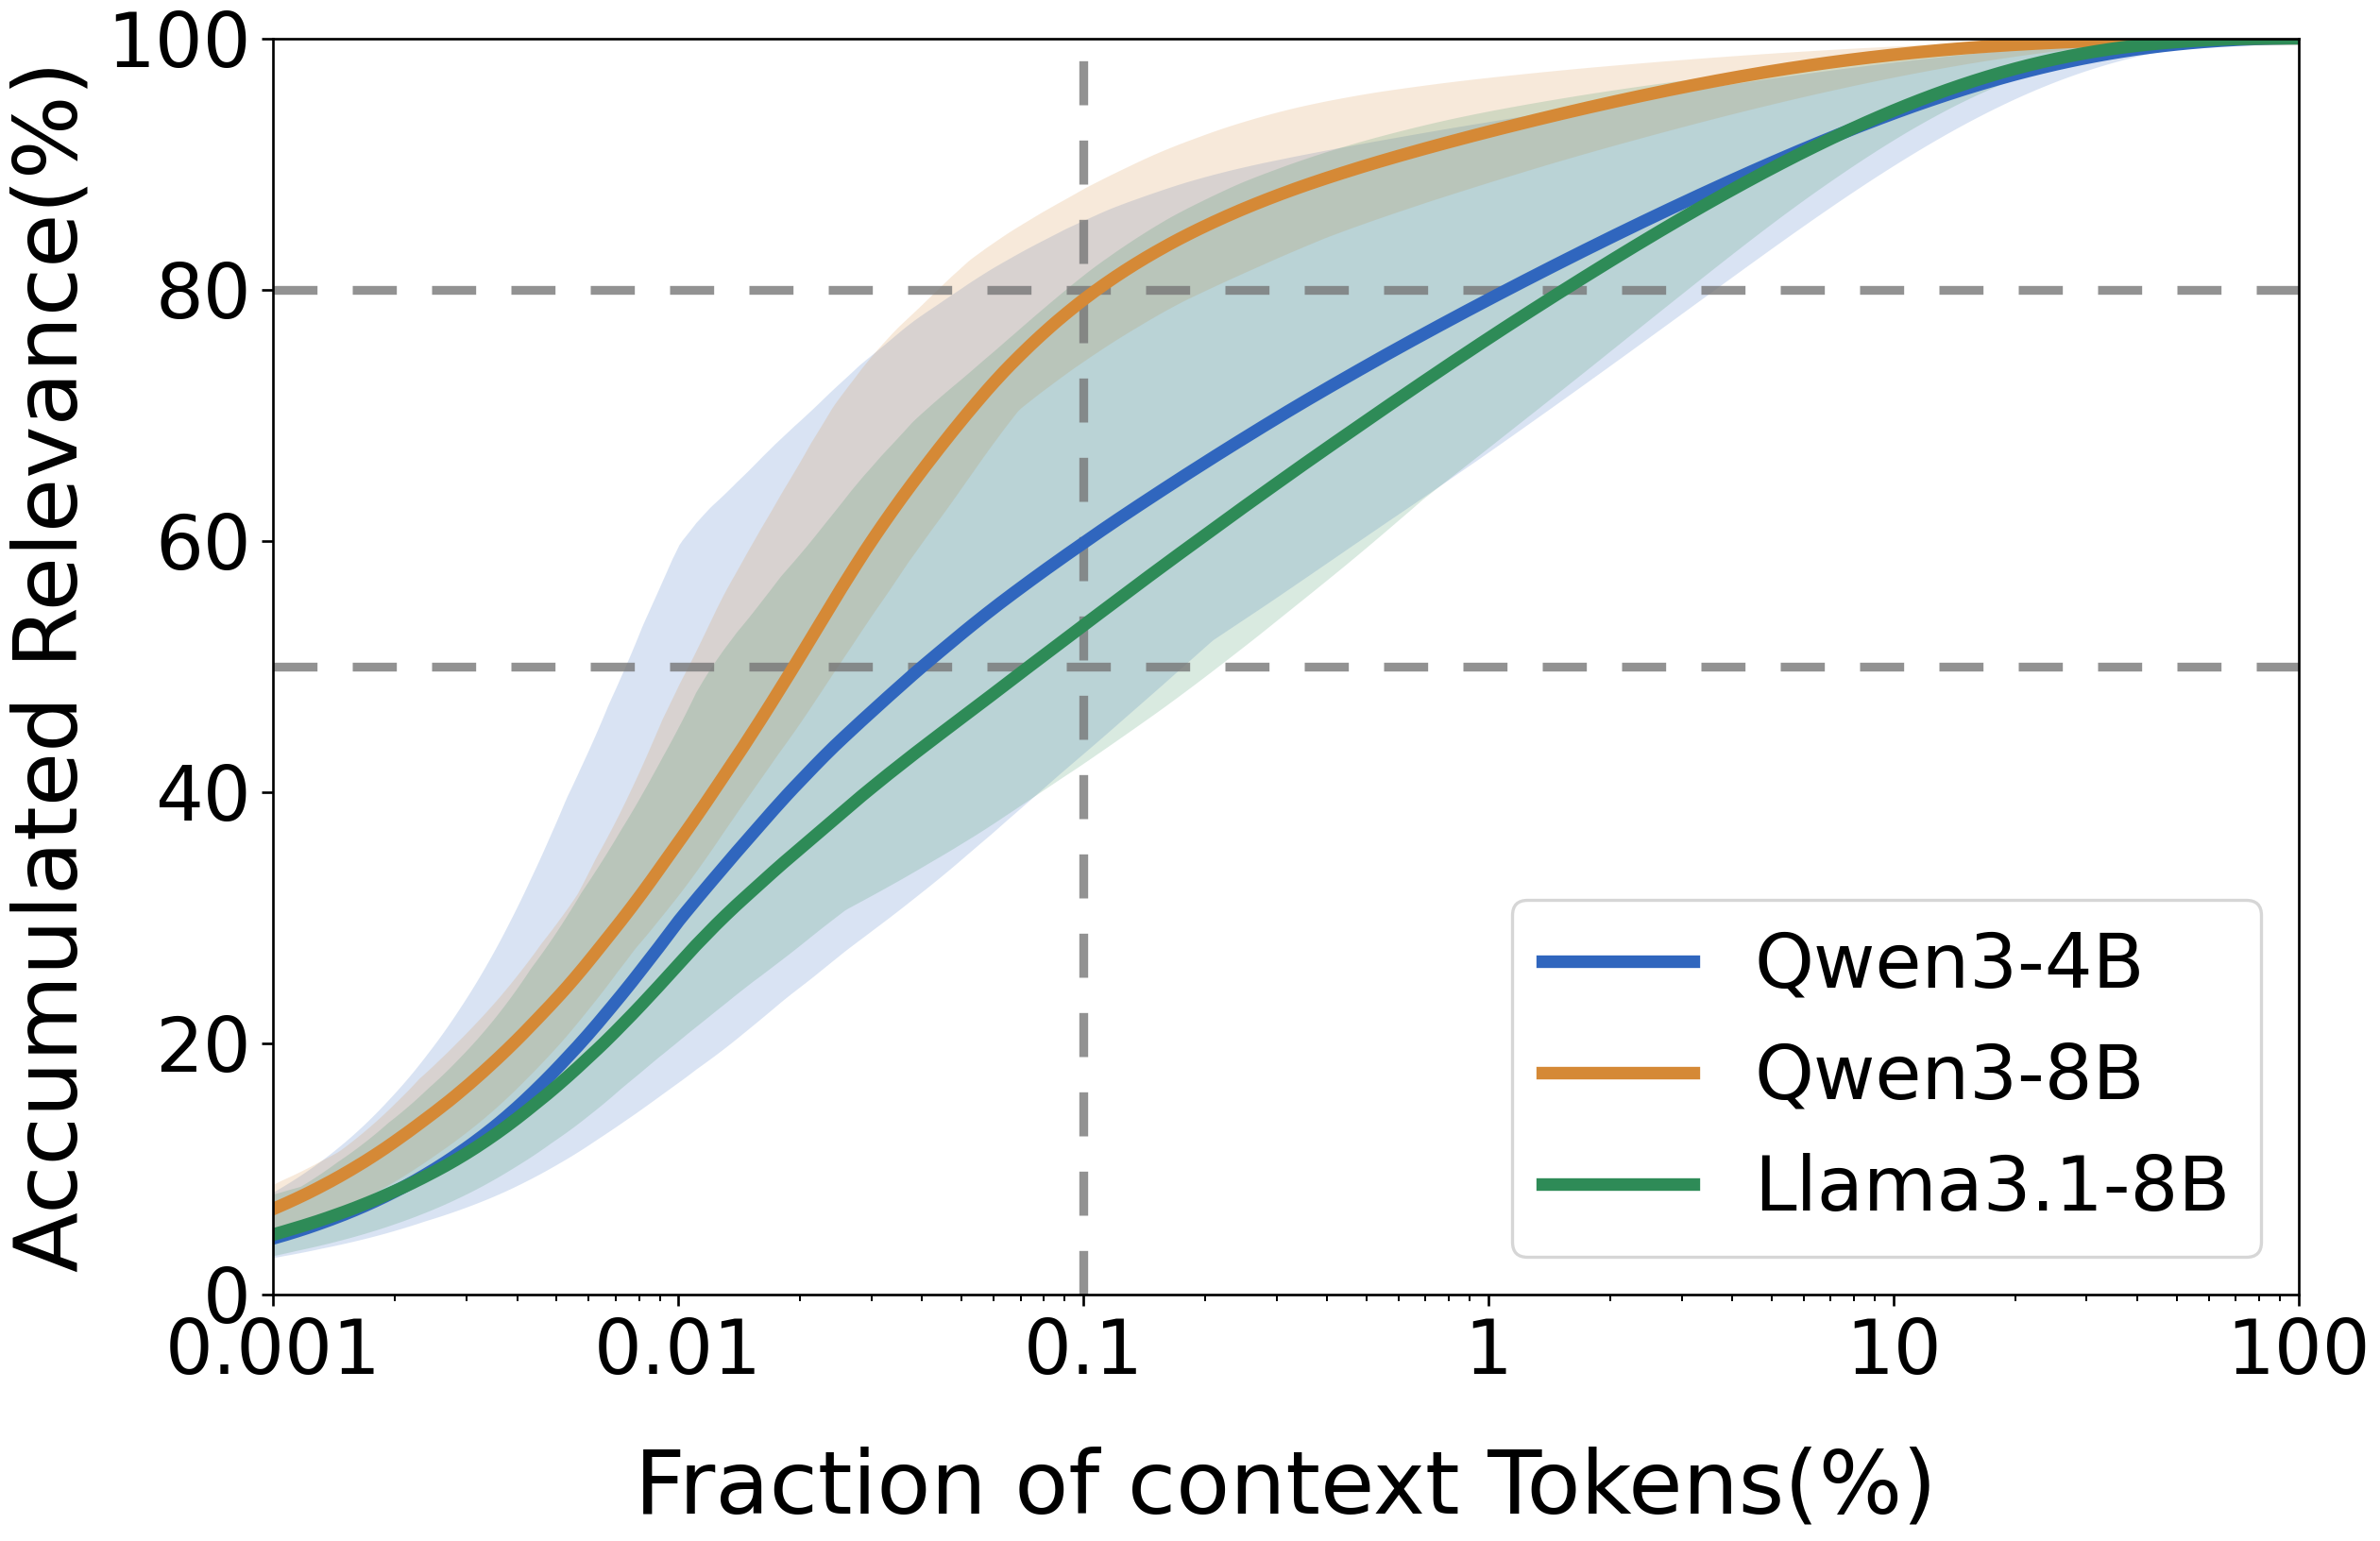
在 128K token 的上下文中,仅占 0.1% 的问题相关 token,就已囊括了不同 LLM 累积相关性分数的约 50% 至 80%。
此即"稀疏相关性"(sparse relevance)——证据虽藏于浩瀚文卷之中,然其分布极不均匀,真正要紧者不过凤毛麟角。然模型生成时,注意力弥散于全文,未必能反复回到那几处关键句上。
传统对策有三,皆有其弊:
| 对策 | 思路 | 弊端 |
|---|---|---|
| 检索增强(RAG) | 外接检索器,抽出 top-k 段落 | 丢弃上下文,模型所见已非全貌;检索器一错,全盘皆输 |
| 上下文压缩 | 用摘要/裁剪把长文压短 | 信息有损,压缩过程本身可能丢失关键证据 |
| 微调/长训练 | 让模型学会长上下文 | 代价高昂,且未必泛化 |
二、核心思想:以模型之眼,照见自身所重
ReContext 之名,可拆而解之:
- Recursive —— 递归。证据池非一蹴而就,可经数轮精炼。
- Evidence —— 证据。从上下文中物化出的、可读的句子。
- Replay —— 重放。将证据复抄一份,插入 prompt 近问题处,令模型再读。
长上下文中,模型本已"心知"哪些 token 要紧(体现于注意力)。ReContext 所为,不过是把这层"心知"显式化——把模型重视的 token 所在之句,原样复制,置于问题之前,使生成时再度入眼。
此处有四要,须铭记:
1. 证据来自原 prompt,非他模型所生成。无幻觉之虞,无信息失真。 2. 原 prompt 全数保留,不予裁剪。重放是"追加"而非"替换",未选中的上下文依旧在位。 3. 不改动模型权重。纯推理时干预,与训练无关,开箱即用。 4. 可递归精炼。多轮重放,每轮在新 prompt 上重计注意力,证据池逐步聚焦。
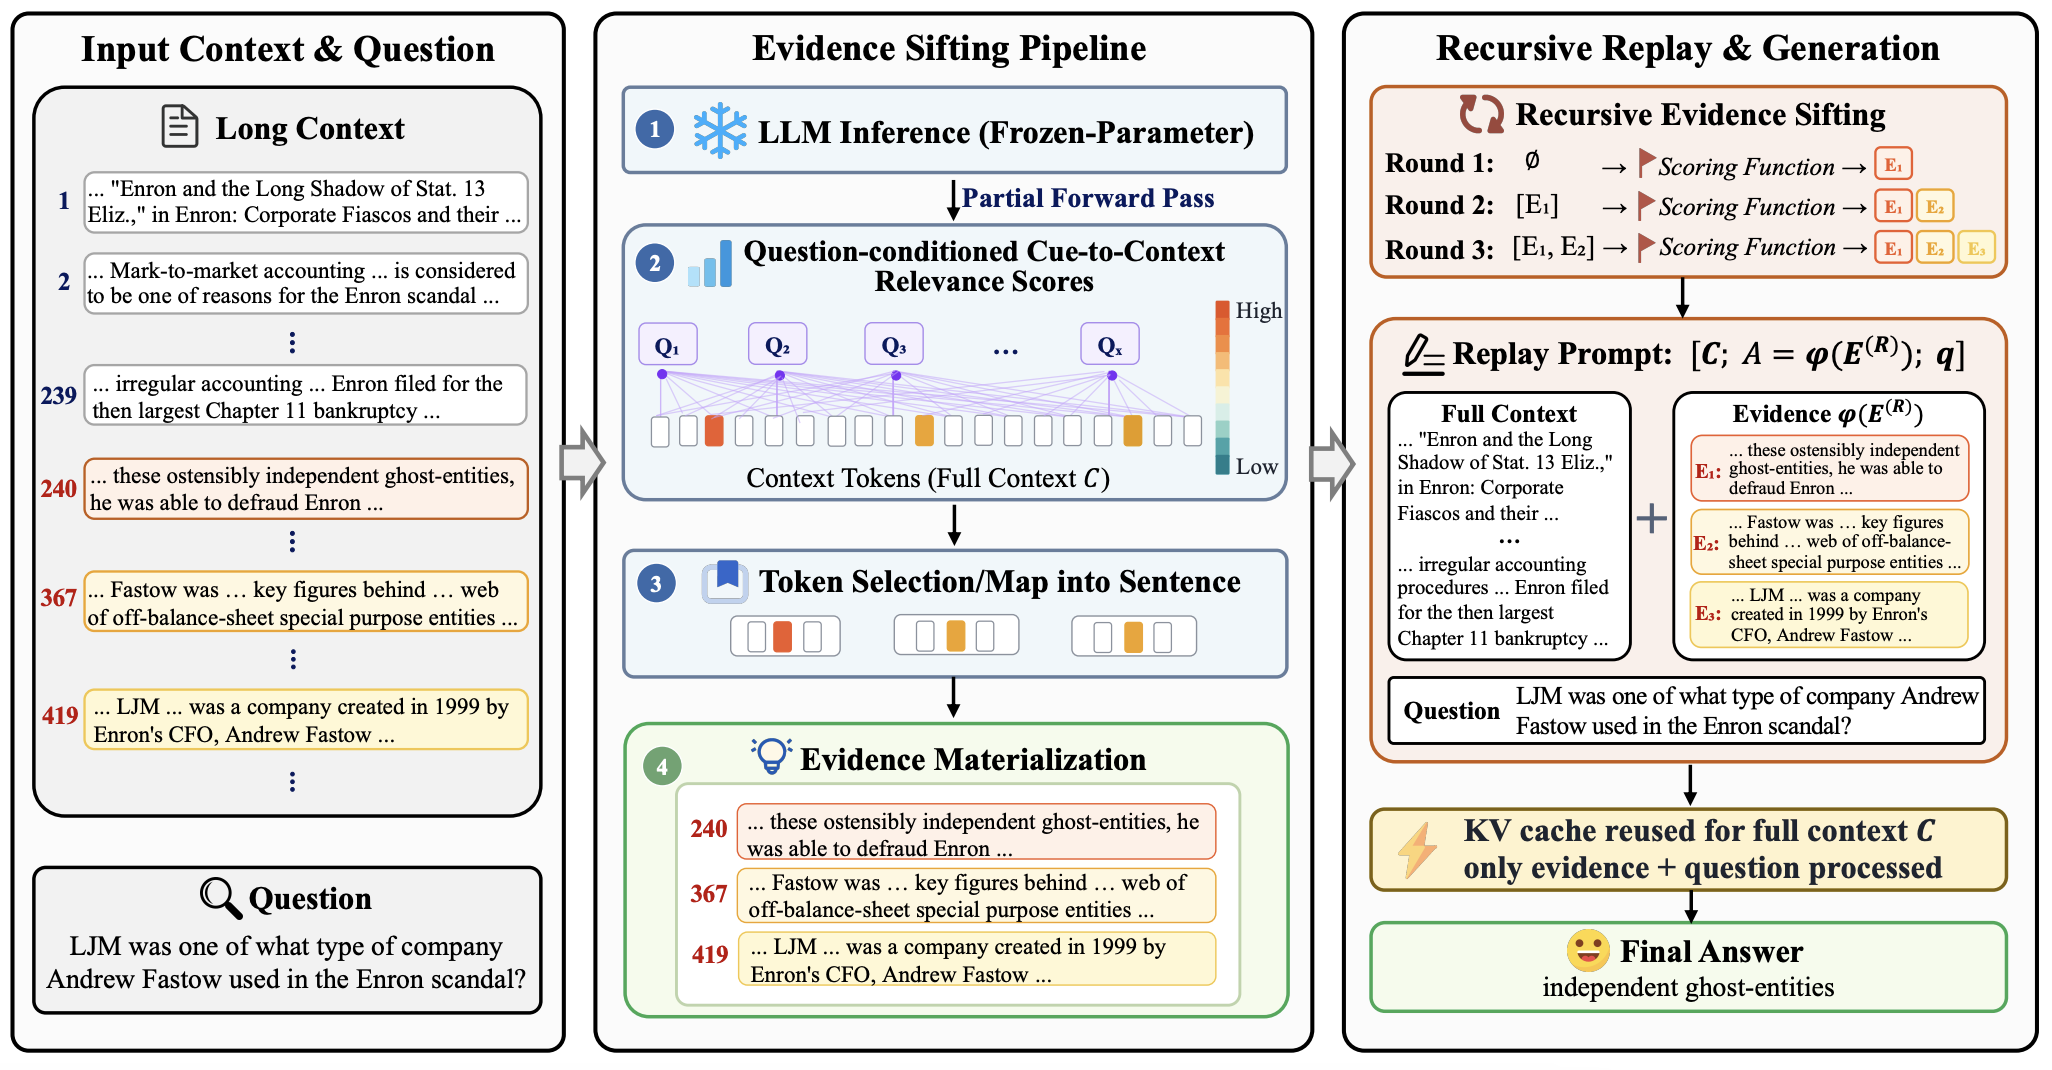
三、整体架构一览
ReContext 仓库之结构,可图示如下:
ReContext/
├── recontext/                      # 核心算法包
│   ├── custom_mixin.py             # ★ 生成逻辑核心:RescaleConfig + CustomGenerationMixin
│   ├── custom_modeling_llama.py    # Llama 改造版(注入 intervention 接口)
│   ├── custom_modeling_qwen3.py    # Qwen3 改造版
│   ├── custom_modeling_qwen3_moe.py# Qwen3-MoE 改造版
│   └── dac_compressor.py           # DAC 基线的 prompt 压缩器
├── eval_datasets/                  # 数据集加载器
│   ├── helmet/                     # HELMET 基准(KILT QA / NarrativeQA / InfiniteBench)
│   ├── clipper/                    # CLIPPER 真伪判别
│   ├── longbenchv2/                # LongBench v2 多选
│   ├── longproc/                   # LongProc 路径行走
│   └── mrcr/                       # MRCR 多针检索
├── recontext_cfgs/                 # 三大 backbone 的超参配置
│   ├── qwen3_4b.yaml
│   ├── qwen3_8b.yaml
│   └── llama3_8b.yaml
├── reproduce_scripts/
│   └── reproduce_recontext_qwen3_4b.sh   # Qwen3-4B 全数据集复现脚本
├── run_eval.py                     # ★ 评测主入口
├── data_utils.py                   # 数据集分发器
├── env.yml                         # conda 环境
└── assets/                         # 论文配图
    ├── teaser.png
    ├── main.png
    └── exp.png
设计上有三层分离,颇为清爽:
- 算法层(
recontext/):模型改造 + 生成逻辑。与数据集无关。 - 数据层(
eval_datasets/):各数据集的加载与后处理。与算法解耦。 - 调度层(
run_eval.py+data_utils.py):解析参数、装配模型与数据、跑评测、存结果。
四、四步算法详解
ReContext 之核心流程,分四步而行。见于 recontext/custom_mixin.py 之 _sentence_replay_sample 与 _multi_round_sentence_replay_sample 方法。
步骤一:注意力读取(Attention Readout)
模型对原始长 prompt 做一次"通读"。ReContext 从问题侧的提示 token(query-side cue tokens)出发,在选定的检索头(retrieval heads)上聚合注意力,为上下文中每个 token 打一个"相关性分数"。
何谓"检索头"?乃注意力机制中某些特定 (layer, head) 对,它们天生善于把 query 与相关 context 对应起来。配置中 selected_heads 即此,例如 Qwen3-4B 选了 16 个头:
selected_heads: "[(20,15),(21,18),(21,31),(22,4),(21,11),(24,29),...]"
聚合之术,见 _aggregate_head_attention:
def _aggregate_head_attention(attention_outputs, selected_heads):
    per_head = []
    for layer, head in selected_heads:
        per_head.append(attention_outputs[layer][:, head,])
    return torch.stack(per_head, dim=0).mean(dim=0).squeeze(1)
即:取出每个选定头在该位置的注意力分布,跨头取均值,得一 [B, L] 的向量,L 为已生成的上下文长度。此向量即每个上下文 token 的"当下相关性"。
然单步注意力噪声颇大。故 ReContext 引入衰减累积(_apply_importance_decay):
def _apply_importance_decay(cur_importance, past_importance, decay_factor):
    cur_importance[:, :-1] += past_importance * decay_factor
    cur_importance = cur_importance / torch.sum(cur_importance, dim=1)
    return cur_importance
即:新注意力 = 当前注意力 + 过去注意力 × 衰减因子,再归一化。decay_factor=0.75 意味历史权重逐步淡去,但不全忘。如此在 context_warmup_steps(默认 8)步内累积,得一个较为稳健的相关性估计。
具体执行时,ReContext 取问题末尾 context_warmup_steps 个 token 作为"回看窗口",逐个 forward,每步聚合注意力并衰减累积。如此既不重跑全文,又能借问题邻近 token 之注意力(此正处于"即将回答"之状态,注意力最聚焦)。
步骤二:证据物化(Evidence Materialization)
得到每个上下文 token 的相关性分数后,ReContext 选出 top-k(或 top-p 核采样)的 token,然后把这些 token 映射回它们所在的句子。
此步关键在于 token → 句子的映射,见 _selected_tokens_to_sentence_info:
1. 把选定 token 的 piece 解码为字符串,拼成全文;
2. 用 nltk.sent_tokenize(或回退到正则)切句,得句子边界;
3. 对每个选定 token,找到其字符区间所属的句子;
4. 去重,得"被选中的句子集合"。
如此,稀疏的 token 重要性,便化为可读的、完整的句子——此即"证据池"。这些句子直接从原 prompt 复制而来,非模型生成,无幻觉之虞。
选 token 之术有三,由 selection_method 决定:
| 方法 | 含义 | 触发条件 |
|---|---|---|
top_k | 取分数最高的前 K 个 token | 仅设 top_k |
top_percentile | 核采样:取累积概率达 p 的 token | 仅设 top_p |
hybrid | 先核采样,若超 K 则退回 top_k | 同时设 top_k 与 top_p |
top_k(设 top_p=0 关闭核采样)。步骤三:递归重放(Recursive Replay)
此步乃 ReContext 之精髓。证据池非一成不变,可经 replay_rounds 轮精炼:
单轮(replay_rounds=1):算一次重要性 → 选 token → 物化句子 → 插入 prompt。
多轮(replay_rounds>1):每轮在前一轮的"扩展 prompt"上重新计算注意力,选新的 token,物化新句子。新句子经去重后追加到证据池。
多轮之妙,在于"递归聚焦"——第一轮选出最显眼的证据,插入后改变了 prompt 结构;第二轮在新结构上重算注意力,可能发现第一轮被遮蔽的次级证据;如此层层深入。
去重逻辑见 _filter_sentence_info_for_replay:以归一化后的句子文本为 key,已插入过的句子不再重复。若某选定 token 所对应句子已全被覆盖("wasted selected position"),还会触发后备选择(backup selection)——从 top-k 之后的排名区间(如 top 9~16)补选,确保每轮的有效证据数不亏。
步骤四:最终生成(Final Generation)
证据池既定,ReContext 构造"重放 prompt",其结构依 replay_position 而异:
replay_position | 重放 prompt 结构 | 说明 |
|---|---|---|
before_question(默认) | [context] + [evidence] + [question] | 证据插在 context 与 question 之间 |
after_question | [context] + [question] + [evidence] | 证据追加在末尾 |
after_question_user_side | 重建用户消息,证据在问题后但仍在 user 侧 | 适配 chat template |
生成时,ReContext 复用步骤一保存的 context KV cache 快照——context 部分已在前向时算过 KV,无需重算。只需对 [evidence] + [question] 部分做一次前向填充 cache,然后正常自回归解码。如此省去对超长 context 的重复计算,效率可保。
证据插入时,默认用模板包裹(wrap_sentence_txt=True):
 below are possible supporting evidence from the context:
<Extra Info>
{evidence_sentences}
</Extra Info>
最终生成之 token 序列中,evidence 部分的 token 会被跳过(不计入输出),仅解码 evidence 之后的真正回答。
五、代码架构:模块与数据流
5.1 模型改造:注入干预接口
ReContext 不改模型权重,但需在 attention 的 softmax 之前插入一个"干预向量"。故对 Llama / Qwen3 / Qwen3-MoE 三类模型各做了一份改造版(custom_modeling_*.py),核心改动有二:
改动一:Attention forward 新增 attention_logits_intervention_vector 参数
以 Qwen3 为例(eager_attention_forward):
attn_weights = torch.matmul(query, key_states.transpose(2, 3)) * scaling
if attention_mask is not None:
    attn_weights = attn_weights + causal_mask
# ★ 关键:在 softmax 之前加上干预向量
if attention_logits_intervention_vector is not None:
    attn_weights = attn_weights + attention_logits_intervention_vector
attn_weights = nn.functional.softmax(attn_weights, dim=-1, ...)
此即 dysco 基线的核心机制:选定 token 的 logit 加 log(strength)(放大其注意力),其余加 0。strength>=99 时则直接 mask 非选定 token 到 -inf(硬选)。
改动二:新增 skip_update_past_key_value 参数
用于回滚 KV cache 的最后一次更新——ReContext 重放前向时,需"借用"模型 forward 算注意力,但不想污染生成用的 cache。此参数在 forward 末尾把刚写入的最后一个 token 的 KV 删去,恢复原状。
改动三:Flash Attention 回退
FlashAttention 不返回 attention weights,亦不支持 logit 干预。故当检测到 attention_logits_intervention_vector is not None 或 output_attentions=True 时,自动回退到 eager attention。这是性能与功能之权衡。
5.2 生成逻辑:CustomGenerationMixin
CustomGenerationMixin 继承自 HF GenerationMixin,覆写 generate 为 rescale_generate,并按 decoding_method 分派:
rescale_generate(input_ids, rescale_config=..., prompt_segment_context=..., ...)
    │
    ├─ 若 rescale_config is not None → _rescale_sample()
    │       │
    │       ├─ 若 prompt_segment_context is not None(即 ReContext 模式)
    │       │       → _sentence_replay_sample()
    │       │           │
    │       │           ├─ replay_rounds > 1 → _multi_round_sentence_replay_sample()
    │       │           └─ replay_rounds == 1 → 单轮逻辑(内联)
    │       │
    │       └─ 否则(dysco 模式)→ 逐 token 在线干预
    │
    └─ 若 use_attnsharp → _sharp_sample()
5.3 Prompt 边界检测
ReContext 须知道 prompt 中"哪里是 context,哪里是 question",方能决定证据插入位置。此逻辑在 run_eval.py 的 build_prompt_segment_context 中,按数据集分四种策略:
| 数据集类型 | 边界检测方式 |
|---|---|
| MRCR | chat template 对话格式,找最后一个 user 消息的起始 token |
| LongBench v2 | 找 \n\nWhat is the correct answer 标记 |
| CLIPPER | 找 \n\n\n 标记 |
| HELMET 系列 | 找最后一个 \n\nQuestion: 或 \nQuestion: 标记 |
prompt_context_token_length(context 长度)与 prompt_question_token_length(question 长度),传给生成逻辑。5.4 完整数据流
一次 ReContext 评测的完整流程:
run_eval.py main()
    │
    ├─ 1. 解析参数 → args
    ├─ 2. 检测模型类型 (llama / qwen3 / qwen3_moe)
    ├─ 3. 若需长上下文,启用 YaRN RoPE 缩放
    ├─ 4. 构建 RescaleConfig (YAML + CLI 覆盖)
    ├─ 5. 加载数据集 (data_utils.load_eval_data)
    │       → 返回 [{input_prompt, reference_output, item}, ...] + eval_func
    ├─ 6. 加载改造版模型 (RescaleXxxForCausalLM)
    │
    ├─ 7. 对每条样本:
    │       ├─ prepare_input_ids() → input_ids
    │       ├─ build_prompt_segment_context() → context/question 边界
    │       └─ model.rescale_generate(input_ids, rescale_config=..., prompt_segment_context=...)
    │               │
    │               ├─ 保存 context KV cache 快照到 CPU
    │               ├─ 回看 context_warmup_steps 个 token,聚合注意力,衰减累积
    │               ├─ 选 top-k token → 映射回句子 → (多轮递归)
    │               ├─ 构造重放 prompt = [context] + [evidence] + [question]
    │               ├─ 从 context cache 快照恢复,前向填充 [evidence+question]
    │               └─ 自回归解码至 EOS
    │
    ├─ 8. 对每条样本调 eval_func(output, ex) → metrics
    └─ 9. 聚合指标,存 results/{method}/{model}/{dataset}_*.json
六、RescaleConfig 配置详解
RescaleConfig 是 ReContext 全部超参的载体,定义于 recontext/custom_mixin.py。配置来源有二:YAML 文件(recontext_cfgs/*.yaml)+ 命令行覆盖。后者优先级更高。
6.1 完整参数表
| 参数 | 类型 | 含义 | 典型值 |
|---|---|---|---|
selected_heads | List[Tuple[int,int]] | 检索头(层, 头)列表 | 16 个头 |
top_k | int | 选 top-k token | 8 / 16 / 32 |
top_p | float | 核采样阈值 | 0.975(或 0 关闭) |
strength | float | dysco 模式的干预强度 | 2.0 |
decay_factor | float | 重要性衰减因子 | 0.75 |
context_warmup_steps | int | 回看窗口大小 | 8 |
intervention_warmup_steps | int | 干预起始偏移(dysco 用) | auto |
dynamic_rescale | bool | dysco 是否动态重计 | True |
wrap_sentence_txt | bool | 证据是否用 | True / False |
replay_position | str | 证据插入位置 | before_question |
use_extension_inputs | bool | 是否真的插入证据(False 则只算不插,作消融) | True |
replay_rounds | int | 重放轮数 | 1 / 2 / 3 |
selection_scope | str | token 选择范围 | context / full_prompt |
dedup_inserted_sentences | bool | 跨轮句子去重 | True |
template_sequences | List[Tensor] | 模板 token 序列(不参与选择) | 各模型的 chat template |
scale_template_tokens | bool | 是否允许选模板 token | False(默认排除) |
6.2 三大 backbone 的默认配置
以 Qwen3-4B 为例(recontext_cfgs/qwen3_4b.yaml):
selected_heads: "[(20,15),(21,18),(21,31),(22,4),(21,11),(24,29),
                  (21,10),(20,16),(21,8),(21,17),(23,30),(20,14),
                  (20,13),(24,13),(20,4),(18,19)]"
top_k: 4096
top_p: 0.975
strength: 2.0
decay_factor: 0.75
context_warmup_steps: 8
intervention_warmup: 'auto'
scale_template_tokens: False
template_sequences:
  - [151644, 8948, 198]            # <|im_start|>system\n
  - [151644, 872, 198]             # <|im_start|>user\n
  - [151644, 77091, 198]           # <|im_start|>assistant\n
  - [151667, 271, 151668, 271]     # <think>\n\n</think>\n\n
dynamic_rescale: True
几个要点:
selected_heads因模型而异。Qwen3-4B / 8B / Llama3-8B 各有一组不同的头。这些头是通过分析模型在检索任务上的注意力行为筛选出来的(论文中有述)。template_sequences列出 chat template 的 token 序列。这些位置的 token 不参与证据选择——否则可能选出<|im_start|>之类无意义 token。intervention_warmup: 'auto':自动检测 chat template 生成前缀的 token 数(即<|im_start|>assistant\n等的开销),作为 dysco 干预的起始偏移。top_k: 4096+top_p: 0.975:默认是 hybrid 模式。但复现脚本中通常用--recontext_top_p 0关闭核采样,纯用top_k。
6.3 命令行覆盖
run_eval.py 提供了大量 --recontext_* 参数,覆盖 YAML。例如:
--recontext_top_k 32 \
--recontext_top_p 0 \
--recontext_replay_rounds 2 \
--recontext_selection_scope context \
--recontext_replay_position before_question
凡命令行未显式设(None)者,沿用 YAML;显式设者,覆盖之。此设计便于扫参。
七、数据集与评估体系
ReContext 在八大长上下文任务上评测,覆盖 QA、多选、叙事、合成、真伪判别五类。数据由 data_utils.py 统一分发。
7.1 数据集一览
| 数据集 | 类型 | 上下文长度 | 评估指标 | 边界检测 |
|---|---|---|---|---|
| kilt_nq / triviaqa / hotpotqa / popqa | 多跳 QA | ~128K | substring exact match + ROUGE | \nQuestion: |
| narrativeqa | 长篇叙事 QA | ~130K | substring + ROUGE | \nQuestion: |
| infbench_qa_eng | 长书 QA | ~130K | substring + ROUGE | \nQuestion: |
| infbench_choice_eng | 长书多选 | ~130K | substring exact match | \nQuestion: |
| clipper | 真伪判别 | ~128K | 配对准确率(TRUE+FALSE 皆对才算对) | |
| longbenchv2 | 多选 | 128K~256K | 选项抽取准确率 | |
| mrcr_{2/4/8}needle | 多针合成检索 | 8K~256K | SequenceMatcher 相似度 | chat template |
| path_walking | 路径推理 | 4K~32K | 路径精确匹配 + 部分匹配 | (LongProc 自有格式) |
7.2 数据文件结构
评测数据须置于 data_eval/ 下(可从 Google Drive 下载):
data_eval/
  clipper/test-100.json
  infbench/infbench_choice_eng_130862_100.json
  infbench/infbench_qa_eng_130862_100.json
  kilt/hotpotqa-dev-multikilt_100_k1000_dep3.json
  kilt/nq-dev-multikilt_100_k1000_dep6.json
  kilt/popqa_test_100_k1000_dep6.json
  kilt/triviaqa-dev-multikilt_100_k1000_dep6.json
  narrativeqa/narrativeqa_130772_100.json
data_utils.load_eval_data(dataset_name) 按数据集名前缀分派到对应的 load_xxx_data 函数,每个函数返回 (data_list, eval_func)。data_list 中每条样本形如:
{
    "input_prompt": "...",        # 已套好模板的完整 prompt 字符串(或对话列表)
    "reference_output": "...",    # 标准答案
    "item": {...}                 # 原始字段,供 eval_func 用
}
7.3 评估指标
各数据集的 eval_func 各异,但都返回 (metrics_dict, details_dict)。例如 CLIPPER 的配对评估(run_eval.py 末段):
if "clipper" in args.dataset:
    num_pairs = len(all_metrics) // 2
    paired_correct = sum(
        1 for i in range(num_pairs)
        if all_metrics[2*i]["accuracy"] == 1 and all_metrics[2*i+1]["accuracy"] == 1
    )
    avg_metrics = {"accuracy": paired_correct / num_pairs}
即:TRUE 样本答对且对应 FALSE 样本答错,方算一对正确。此评估比单条准确率更严苛,能惩罚"全答 TRUE"之类偷懒策略。
7.4 主结果

ReContext 在 Qwen3-4B、Qwen3-8B、Llama3-8B 三个 backbone 上,于八任务平均排名皆居首。增益跨 QA、多选、叙事、合成四类任务一致,无需重训模型。
八、基线方法对比
run_eval.py 通过 --decoding_method 切换五种方法:
| 方法 | --decoding_method | 模型类 | 核心机制 |
|---|---|---|---|
| Flash(标准生成) | flash | 原版 | 直接 model.generate(),无干预 |
| DySCO | dysco | Rescale 版 | 逐 token 在线干预:每步重计注意力,选 top-k token,加 log(strength) 到其 attention logit |
| ReContext | ReContext | Rescale 版 | 句子重放:算一次注意力,物化句子,插入 prompt,再生成 |
| AttnSharp | attnsharp | Rescale 版 | 注意力锐化:Q,K /= sqrt(temperature),整体 sharpen |
| DAC | DAC | 原版 | 离线 prompt 压缩:用预压缩的数据(keep 0.5 / 0.25) |
| 维度 | DySCO | ReContext |
|---|---|---|
| 干预时机 | 生成时逐 token | 生成前一次性 |
| 干预对象 | attention logits(连续值) | prompt 结构(插入证据句) |
| 证据形态 | token 级(隐式) | 句子级(显式可读) |
| 是否改 prompt | 否 | 是(追加 evidence) |
| 是否保留全文 | 是 | 是 |
| 计算开销 | 每步重算注意力 | 一次性 + cache 复用 |
| 多轮精炼 | 否(每步独立) | 是(replay_rounds) |
DAC(Prompt 压缩):recontext/dac_compressor.py 实现了一个基于 PPL + 注意力融合的压缩器。但仓库中 DAC 评测用的是离线已压缩数据(data_eval_compressed/keep_0p5 等),而非在线压缩。此为基线,对比"压缩 vs 重放"两种长上下文处理哲学。
九、使用教程:从零复现
9.1 环境准备
# 1. 克隆仓库
git clone <repo_url> ReContext
cd ReContext

# 2. 创建 conda 环境
conda env create -f env.yml
conda activate recontext

# 3. 安装 FlashAttention(关键!无则无法跑 128K 上下文)
python -m pip install flash_attn==2.8.3
若源码编译失败(CUDA/PyTorch 版本不匹配),从 FlashAttention releases 选对应 wheel,例如:
wget -O flash_attn-2.8.3+cu12torch2.6cxx11abiTRUE-cp310-cp310-linux_x86_64.whl \
  "https://github.com/Dao-AILab/flash-attention/releases/download/v2.8.3/flash_attn-2.8.3+cu12torch2.6cxx11abiTRUE-cp310-cp310-linux_x86_64.whl"
python -m pip install ./flash_attn-2.8.3+cu12torch2.6cxx11abiTRUE-cp310-cp310-linux_x86_64.whl
环境关键依赖(env.yml 摘要):
- Python 3.10
- PyTorch 2.6.0 + CUDA 12.4
- transformers 4.57.3(★ 重要:代码适配此版本,他用或报错)
- flash_attn 2.8.3
- nltk(句子切分,ReContext 物化证据时用)
- pytrec-eval, rouge-score(评估用)
9.2 数据准备
# 从 Google Drive 下载 data_eval 压缩包,解压至仓库根目录
# 最终结构:
# ReContext/data_eval/clipper/test-100.json
# ReContext/data_eval/kilt/...
# ReContext/data_eval/narrativeqa/...
# ReContext/data_eval/infbench/...
9.3 模型准备
支持三个 backbone(HuggingFace Hub 自动下载):
Qwen/Qwen3-4BQwen/Qwen3-8Bmeta-llama/Llama-3.1-8B(需有访问权)
9.4 运行单次评测
最简命令(Qwen3-4B 在 KILT-NQ 上跑 ReContext):
CUDA_VISIBLE_DEVICES=0 python run_eval.py \
    --seed 42 \
    --generation_seed 23 \
    --dataset kilt_nq \
    --test_size -1 \
    --model Qwen/Qwen3-4B \
    --max_tokens 20 \
    --temperature 0.0 \
    --top_p 1.0 \
    --max_model_len 131072 \
    --enable_yarn \
    --output_dir results \
    --decoding_method ReContext \
    --recontext_cfgs_path recontext_cfgs/qwen3_4b.yaml \
    --recontext_top_p 0 \
    --recontext_top_k 32 \
    --recontext_strength 2.0 \
    --recontext_decay_factor 0.75 \
    --recontext_ctx_warmup 8 \
    --recontext_interv_warmup auto \
    --recontext_replay_rounds 1 \
    --recontext_selection_scope context \
    --recontext_dedup_inserted_sentences 1 \
    --recontext_wrap_sentence_txt 0 \
    --recontext_replay_position before_question \
    --recontext_use_extension_inputs 1 \
    --stop_on_newline
关键参数释义:
--max_model_len 131072:128K 上下文窗口--enable_yarn:启用 YaRN RoPE 缩放(Qwen3 原生 32K/128K,跑 128K 需此)--stop_on_newline:遇换行停止(QA 类短答案任务用,避免模型啰嗦)--test_size -1:跑全量(100 条);设正数 N 则取前 N 条--max_tokens 20:QA 类只需短答案;多选题(infbench_choice)需 4096(要 CoT)
9.5 运行复现脚本
仓库提供了 Qwen3-4B 全数据集的扫参脚本:
# 先 dry-run 看看会跑哪些命令
DRY_RUN=1 bash reproduce_scripts/reproduce_recontext_qwen3_4b.sh

# 确认无误后正式跑
CUDA_VISIBLE_DEVICES=0 bash reproduce_scripts/reproduce_recontext_qwen3_4b.sh
脚本内含 8 个数据集的配置,每个数据集的 top_k / replay_rounds / selection_scope 各异(已调好):
| 数据集 | max_tokens | stop_on_newline | top_k | rounds | scope |
|---|---|---|---|---|---|
| kilt_nq | 20 | ✓ | 32 | 1 | context |
| kilt_triviaqa | 20 | ✓ | 8 | 3 | context |
| kilt_hotpotqa | 20 | ✓ | 8 | 3 | context |
| kilt_popqa_3 | 20 | ✓ | 32 | 1 | context |
| narrativeqa | 100 | ✗ | 8 | 2 | full_prompt |
| infbench_qa | 10 | ✗ | 8 | 2 | full_prompt |
| infbench_choice | 4096 | ✗ | 16 | 2 | context |
| clipper | 512 | ✗ | 8 | 2 | context |
full_prompt scope(允许从问题部分也选 token)。9.6 结果文件
结果存于 results/ReContext/Qwen-Qwen3-4B/ 下,文件名编码了全部超参,例如:
kilt_nq_modlen131072_max20t0.0p1.0_dynamicrescalehead<hash8>k32p0.0s2.0df0.75
_ctxwarm8intwarm<n>_wrapsent0_useext1_thinkFalse_42and23_testsz-1.json
同目录还会有 *.scores.json,仅含平均指标,便于批量比较。--auto_skip 可跳过已完成的(文件已存在则跳过)。
9.7 跑基线对比
把 --decoding_method 改为对应值即可:
# Flash 基线
--decoding_method flash

# DySCO 基线(逐 token 在线干预)
--decoding_method dysco

# AttnSharp 基线
--decoding_method attnsharp --attention_logits_temperature 0.5

# DAC 基线(需先准备 data_eval_compressed/)
--decoding_method DAC --dac_compression_rate 0.5
十、实战示例与调参指南
10.1 调参心法
ReContext 的超参虽多,然其要者不过四端:
一曰"看多远"——context_warmup_steps
回看窗口大小。太小则注意力估计噪声大;太大则计算开销增。默认 8,已为 sweet spot。一般不需调。
二曰"选多少"——top_k / top_p
top_k小(8~16):证据精炼,聚焦最相关。适合短答案 QA、单跳任务。top_k大(32+):证据宽泛,覆盖多跳。适合多跳 QA、需综合多处证据的任务。top_p:核采样,自适应数量。但复现脚本中多关闭(设 0),纯用top_k更可控。
replay_rounds
- 1 轮:快,适合简单任务(单跳 QA)。
- 2~3 轮:递归精炼,适合多跳、需深挖的任务(多选、真伪判别)。
- 超过 3 轮:收益递减,且可能引入噪声。
selection_scope
context:只在 context 部分选 token。最常见,避免选出问题本身的 token。full_prompt:全 prompt 皆可选。适合叙事类(narrativeqa)——此类任务的问题本身也可能含线索。
10.2 常见问题排查
Q1:跑 128K 上下文时 OOM?
- 确认装了 FlashAttention 2(
pip show flash_attn应有+cu12之类后缀) - 确认
--max_model_len不超模型上限 - Qwen3 跑 128K 须
--enable_yarn - 8B 模型在单卡 24G 上跑 128K + ReContext 可能吃紧,ReContext 多轮需额外存 context KV cache 快照(CPU),显存压力主要在 forward 时
正常。ReContext 算注意力时自动回退到 eager attention,慢一些但能跑。此为设计内行为,见 LlamaFlashAttention2.forward 的回退逻辑。
Q3:句子切分报错 / 不准?
确保装了 nltk 且下载了 punkt:
import nltk
nltk.download('punkt')
nltk.download('punkt_tab')
若 nltk 不可用,代码会回退到正则切句(_SENTENCE_BOUNDARY_RE),效果略差但不报错。
Q4:CLIPPER 评估报"pair mismatch"?
CLIPPER 数据须严格成对(TRUE 在偶数位,FALSE 在奇数位,且 false_idx = true_idx + 1000)。若用 --test_size 截断,须保证截断后仍成对(即 test_size 为偶数)。脚本默认 test_size=-1(全量)无此患。
Q5:结果文件名太长?
文件名编码了全部超参以便追溯,确实长。可用 --auto_skip 跳过已完成的,或写脚本批量读 *.scores.json 汇总。
10.3 调试:查看选了哪些句子
ReContext 在运行时会打印每轮选中的句子:
[ReContext replay round 1] selected sentences before dedup:
The capital of France is Paris.
...
[ReContext replay round 1] inserted sentences after dedup:
The capital of France is Paris.
...
若想更深入分析,可用 --recontext_importance_dump_dir ./dumps,每条样本会存一个 .pt 文件,含:
input_token_ids/input_tokens:原 prompt 的 tokencontext_token_length:context 边界importance_details:每步的注意力权重 + 衰减后分数generation_logging:选中的句子、位置、轮次信息
import torch
data = torch.load("dumps/kilt_nq_sample000_topk32_rounds1_ctxwarm8.pt")
print(data["generation_logging"]["round_inserted_sentences"])
十一、设计哲学与局限
11.1 设计哲学
ReContext 之设计,可归纳为四条原则:
一曰"借模型之智,非代模型之劳"
ReContext 不外接检索器,不另训模型。它借模型自身的注意力——这本就是模型"心之所向"——作为相关性信号。模型擅长什么,ReContext 就放大什么。此为"顺势而为",非"另起炉灶"。
二曰"显式胜于隐式"
DySCO 直接改 attention logits,是"隐式"干预——模型不知自己被改了。ReContext 把证据物化为可读句子,插入 prompt,是"显式"提示——模型"看见"自己重视什么。后者更接近人类阅读时的"划重点"行为,也更易被模型利用。
三曰"保留胜于裁剪"
RAG 丢弃上下文,DAC 压缩上下文,皆有信息损失。ReContext 原文全留,证据是"追加"而非"替换"。即使证据选错了,模型仍可见全文,不至于一错再错。此为"宁多勿少"。
四曰"递归胜于一次"
单次选证据难免有偏。多轮重放,每轮在新 prompt 上重算注意力,能发现被遮蔽的次级证据。此为"步步精炼",如琢如磨。
11.2 局限与展望
局限一:依赖"好的检索头"
selected_heads 是预设的,因模型而异。换新模型须重新筛选头——此筛选过程不在本仓库代码中(论文另有述)。对未覆盖的模型,用户须自行分析注意力行为选头。
局限二:batch size 限为 1
代码中多处 assert batch_size == 1。ReContext 的逐样本 prompt 重构、KV cache 快照等机制,与批量推理不兼容。大规模评测须靠多卡数据并行。
局限三:仅支持 decoder-only 模型
代码中明确 if self.config.is_encoder_decoder: raise ValueError。 encoder-decoder 架构(如 T5)不支持。
局限四:句子切分依赖 nltk
对英文效果好,对中文等其他语言可能不准。若用于中文长上下文,建议替换 _collect_sentence_char_spans 中的切句逻辑。
局限五:多轮重放有计算开销
每轮需重跑一次 context cache 恢复 + evidence+question 前向。replay_rounds=3 比 =1 慢约 2 倍(context 部分已缓存,主要开销在 evidence 增长后的前向)。
展望:
- 检索头的自动筛选工具(降低新模型适配成本)
- 批量推理支持(提升评测吞吐)
- 多语言句子切分(扩展应用范围)
- 与 RAG 结合(ReContext 作 reranker,RAG 作初筛)
附录:术语表
| 术语 | 释义 |
|---|---|
| Retrieval Head(检索头) | 注意力机制中善于把 query 与相关 context 对应的 (layer, head) 对。ReContext 用其注意力作为相关性信号。 |
| Attention Readout(注意力读取) | 从选定头的注意力分布中提取 token 相关性分数的过程。 |
| Evidence Materialization(证据物化) | 把选定的 token 映射回其所在句子,形成可读证据池的过程。 |
| Recursive Replay(递归重放) | 多轮重复"算注意力 → 选 token → 物化句子 → 插入 prompt"的过程,每轮在前一轮的扩展 prompt 上重算。 |
| Replay Position(重放位置) | 证据插入 prompt 的位置:before_question / after_question / after_question_user_side。 |
| Intervention Vector(干预向量) | dysco 基线中加到 attention logits 上的向量,用于放大选定 token 的注意力。 |
| Context Warmup(上下文预热) | 回看窗口大小,决定用多少个 query token 的注意力来估计上下文相关性。 |
| Decay Factor(衰减因子) | 历史重要性权重在累积时的衰减系数,控制"记忆"长度。 |
| YaRN | 一种 RoPE 缩放方法,用于扩展模型的原生上下文长度。Qwen3 跑 128K 须启用。 |
| DySCO | ReContext 的前身方法,逐 token 在线干预 attention logits,不物化为句子。 |
| DAC | Dynamic Attention Compression,基于 PPL + 注意力融合的 prompt 压缩方法,作基线。 |
| HELMET | 一套长上下文评测基准,含 KILT QA、NarrativeQA、InfiniteBench 等。 |
| CLIPPER | 真伪判别任务,要求模型判断陈述是否被上下文支持,配对评估。 |
| MRCR | Multi-Retrieval and Context Reasoning,多针合成检索任务。 |
*本文档基于 ReContext 仓库源码(commit 截至 2026 年)编撰,旨在解析架构与设计思想,并提供可操作的使用教程。如与论文表述有出入,以论文为准。*