MiniMind-O:0.1B 语音原生全模态开源模型
一张 3090,两小时,从零训出一个「能听、能看、能想、能说」的端到端 Omni 模型——并把它拆给你看。
目录
- 目录 · 九重剖析
- 一、定位与背景Why a tiny Omni model at all?
- 1.1 两条路:级联 vs 端到端
- 1.2 它是 MiniMind 系列的「第三站」
- 二、核心架构剖析Thinker–Talker dual path
- 2.1 四个「器官」与一个小脑
- 2.2 特征如何喂进语言模型
- 2.3 参数总账(一次看清「谁在转、谁冻结」)
- 2.4 架构全景图
- 三、三大规模敏感设计The soul of the paper
- ① 中层语义桥接(middle-layer semantic bridging)
- ② MTP 八码本低秩接口(parameter-efficient 8-codebook interface)
- ③ 九流多模态序列格式(released multimodal sequence format)
- 四、训练与数据Train in hours, not weeks
- 4.1 数据构成(full 版)
- 4.2 硬件与耗时(full,4×RTX 3090,DDP)
- 五、评测与数字Does it think and speak alike?
- 5.1 核心数字(Talker hidden size = 768)
- 5.2 消融要点
- 六、能力边界与局限Honest about its ceiling
- 七、上手指南Clone · Train · Play
- 7.1 环境与资源
- 7.2 训练(trainer/ 下,mini 三阶段示意)
- 7.3 推理与玩
文本版 · 供搜索与朗读
深度研究 · MiniMind-O:0.1B 语音原生全模态开源模型
DEEP RESEARCH · 全模态模型
MiniMind-O:0.1B 语音原生全模态开源模型
一张 3090,两小时,从零训出一个「能听、能看、能想、能说」的端到端 Omni 模型——并把它拆给你看。
作者 Jingyao Gong(独立研究者)
开源 2026-05-05
协议 Apache-2.0
规模 ~0.1B(可训练 113M)
报告 arXiv:2605.03937
仓库 github.com/jingyaogong/minimind-o
目录 · 九重剖析
01定位与背景:为何要「小模型 Omni」
02核心架构剖析:Thinker–Talker 双路径
03三大规模敏感设计(报告灵魂)
04训练与数据:4×3090,全量不足 4 小时
05评测与数字:想与说是否一致
06能力边界与局限(坦诚列短)
07上手指南:clone、训、推、玩
08定位判断与教育/研究价值
09参考与出处
一、定位与背景Why a tiny Omni model at all?
全模态交互之难,不在「听、看、说」各自能成,而在它们要同一个闭环里协作:听清、看懂、想明、说出,且你一插话它就得停。GPT-4o 让世人记住了这件事;MiniMind-O 想证明的是——这活儿不必烧千亿参数也能干,且能让你从第一行代码读起。
1.1 两条路:级联 vs 端到端
做语音助手,最直白是三段式级联:用户语音 → ASR 转文字 → LLM 写答 → TTS 读出来。工程好拼,却有三处硬伤:
延迟叠加:三模块串行,整体更慢;
信息损耗:语音先被转成文字,语气、停顿、情绪在文本中介里丢了一截;
LLM 在声学环路之外:发音、节奏、音色控制出错时,难归因于一个共享表征。
GPT-4o / Qwen-Omni / Moshi 走的是端到端:语音直接进模型,内部自完成「听–想–说」,不经文字转写。代价是海量数据与算力。MiniMind-O 取了条「接地气」的路:把听、看交给现成专家编码器,想交给 MiniMind,说交给轻量 Talker。
1.2 它是 MiniMind 系列的「第三站」
阶段项目能力
第一站mini / mini-v2会读写文本(语言模型)
第二站mini-v能看图再答(视觉多模态)
第三站mini-o听语音、看图片、出文本、直接说话——完整 Omni 闭环
关键洞见:「小」不只是约束,更是实验把手。主干仅 0.1B,每个被加进来的模块都得挤过极小的 hidden 空间——于是那些「在大模型上不过图方便」的组件,在 0.1B 下必须变得显式、可测、可复现。MiniMind-O 因此成了一个绝佳的「全模态压力测试台」。
二、核心架构剖析Thinker–Talker dual path
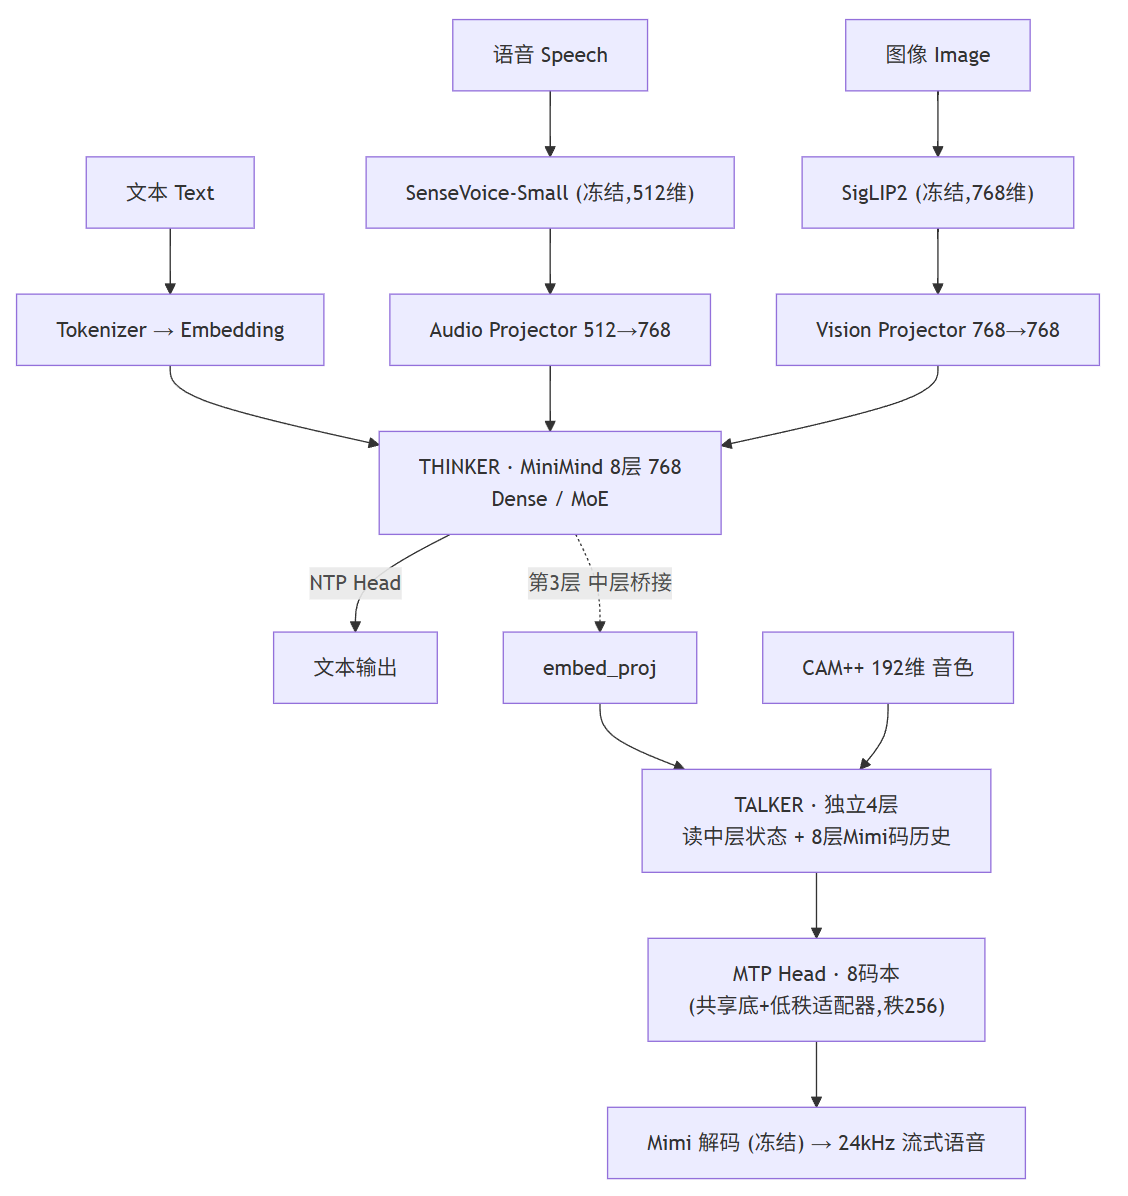
一言以蔽之:语义与声学解耦。Thinker 负责「想」(理解多模态、生成语义),Talker 负责「说」(从语义状态自回归地吐出音频码)。二者各司其职,又靠一处「桥」相连。
2.1 四个「器官」与一个小脑
👂 耳 · SenseVoice-Small 冻结
语音 → 512 维特征,16kHz,~234M 参数(冻结)。
👁 眼 · SigLIP2 base-p32-256 冻结
图像 → 768 维特征,256×256,~94.55M(冻结)。
👄 嘴 · Mimi 编解码 冻结
波形 ↔ 离散 audio codes:8 码本、12.5Hz、24kHz,单码本大小 2048,~96.15M(冻结)。
🎙 声带特征 · CAM++ 预计算
192 维说话人嵌入,控制合成音色,随样本预计算。
🧠 大脑 · Thinker(MiniMind Transformer)
8 层、hidden 768。可训练参数 Dense 63.91M / MoE 198.42M。接收文本 embedding,及经 MLP 投影器注入的语音/视觉特征。
🗣 发声模块 · Talker(独立 4 层 MiniMind blocks)
可训练 47.05M / 114.30M。权重匹配时由 Thinker 末 4 块初始化;自回归预测 8 层 Mimi 码,形成流式语音。
2.2 特征如何喂进语言模型
巧而不繁:在输入序列里预留占位符,再用轻量 MLP 把编码器输出映射到 LLM 的 embedding 空间,替换掉占位符——语音用 <audio>,图像用 <image>。不动 Transformer 结构本身,只是多了一条条注入通道。
投影器映射可训练参数
Audio projector(MMAudioProjector)512 → 7680.99M
Vision projector(MMVisionProjector)768 → 7681.18M
2.3 参数总账(一次看清「谁在转、谁冻结」)
模型可训练主干冻结外部运行时总加载
minimind-3o(Dense)113.13M424.70M537.83M
minimind-3o-moe314.89M424.70M739.59M
注意:真正训练的只是 Thinker + Talker + 两个投影器(~113M / ~315M);SenseVoice、SigLIP2、Mimi 始终是冻结的外部模块。MoE 版用专家层增加总容量,但单次前向激活参数仍与 Dense 版相当。
2.4 架构全景图
图:MiniMind-O 推理数据流。冻结模块(SenseVoice / SigLIP2 / Mimi / CAM++)以暖色描边;Thinker 与 Talker 为可训练主干;绿线为「中层语义桥接」——Talker 从 Thinker 第 3 层取状态。
三、三大规模敏感设计The soul of the paper
报告真正的贡献,不在「又跑通一个模型」,而在它挖出了三个「规模敏感」的设计点——这些在大模型上「图方便也能混过去」的组件,在 0.1B 下被逼成必须显式回答的问题。此三者,乃全文之魂。
① 中层语义桥接(middle-layer semantic bridging)
Talker 该从 Thinker 的哪一层读语义状态?多数同类方案(如 Qwen-Omni 系)从中间层取隐藏状态,MiniMind-O 把「为何是中间层」讲得极透:
太浅(如 embedding 层):还停留在 token 身份与跨模态特征注入阶段,缺上下文来消歧发音与句法。经典例子——多音字「地」:在「土地」读 dì,在「开心地笑」读 de,embedding 分不清。
太深(最后一层):已被 LM head 的 next-token 预测「污染」,隐藏状态里带着强烈的文本 token 选择噪声与分类头几何结构,对声学反成干扰。
实做:默认从 num_hidden_layers // 2 - 1(即 8 层中的第 3 层)取 Thinker 隐藏状态,经可学习的线性投影 embed_proj 映射到 Talker 空间,再与 Mimi 码历史融合。论文报告:把桥接层往后推,Talker 的 CER 会明显上升。
② MTP 八码本低秩接口(parameter-efficient 8-codebook interface)
Talker 用 MTP(Multi-Token Prediction)一次并行预测多层 Mimi codes,从而支持流式低延迟语音。难点在参数:Mimi 是 8 码本(每层 2048 类),若给 8 码本各配一套独立嵌入表 + 输出头,参数量直接爆表。
解法:非满秩「共享底 + 低秩适配器(LoRA)」。TalkerEmbedding 与 TalkerHead 各自只维护一套共享大参数表,再给每个码本配一组低秩残差适配器。
· 统一秩从 16 拉到 256,loss 与码本准确率持续改善,但边际收益递减;发布版取秩 256 作平衡。
· 解耦实验关键结论:TalkerHead 的秩比 TalkerEmbedding 的秩影响更大——嵌入端只需读最近一段音频码历史,输出端却要同时预测 8 层码本分布,任务难出一个量级。这让「低秩接口」成了有实证支撑的设计选择,而非偷懒捷径。
③ 九流多模态序列格式(released multimodal sequence format)
架构之外,更要定义「一条训练样本长啥样」。MiniMind-O 的做法极工整:每条样本是一张 9 流表——8 条音频码流 + 1 条文本流,对齐在同一序列位置。
Thinker 只看文本流,内含 <audio> / <image> 占位符(训练时被替换为投影后的特征);
Talker 只看 8 条音频流;
助理回复开始前,音频流全是 pad + 可选参考码;回复开始后才填目标 Mimi 码;loss 仅在目标区计算;
说话人控制塞进同一格式:speaker token + 右对齐参考 codec prompt + CAM++ 192 维。参考音色右对齐放在目标语音前、不参与 loss——模型学的是「照此音色去生成内容」,而非「复读参考音频」;推理时换嵌入/参考码即换声线,不必动 Thinker 参数。
联合损失:各层码本的交叉熵之和,把「想得对不对」与「说得准不准」直接耦合进同一目标。
四、训练与数据Train in hours, not weeks
开源的不仅是代码与权重,还有训练数据本身(mini 与 full 两套 Parquet)。Omni 系统若只开源代码、却把对齐数据/码本目标/模态布局隐含掉,便难以复现——MiniMind-O 把这点也补齐了。
4.1 数据构成(full 版)
子集样本数规模语言占比
sft_t2a(文→音)1,248,923输出语音 ~1636h中英各约 45%
sft_a2a(音→音)414,024输入 ~1712h / 输出 ~423h中文 >70%
sft_i2t(图→文)—视觉对齐—
数据来源含 VoiceAssistant-400K、UltraChat-300K-SLAM-Omni、Qwen3-TTS 合成多说话人音频等。mini 子集:sft_t2a_mini 输出 ~470h;sft_a2a_mini 输入 ~74.64h / 输出 ~56.60h。
4.2 硬件与耗时(full,4×RTX 3090,DDP)
阶段配置耗时
T2A 全参数 SFT1 epoch~45 min
A2A 全参数 SFT3 epochs~75 min
Audio projector A2A 对齐1 epoch~25 min
I2T 全参数 SFT1 epoch~45 min
Vision projector I2T 对齐1 epoch~45 min
完整 Dense / MoE 周期—< 4 小时
门槛之低:mini 数据集在单张 RTX 3090 上约 2 小时即可跑通完整 Thinker–Talker 链路;CPU 亦可快速推理。这是端到端语音模型里相当「炸裂」的效率,让个人复现成为可能。
五、评测与数字Does it think and speak alike?
MiniMind-O 的评估范式本身就有意思:它不跟你比声音多好听(不测 MOS/WER),而测「想」与「说」是否一致。具体做法——用 Qwen3-ASR-Flash 把 Talker 生成的语音转写回来,再与 Thinker 自己生成的回复文本比对,算 CER(字符错误率)。这直接量的是:同一个模型里,语义预测与语音生成是否对齐。
5.1 核心数字(Talker hidden size = 768)
变体Thinker–Talker 一致性 CER ↓音色克隆相似度 ↑
minimind-3o(Dense)0.08970.5995
minimind-3o-moe0.09000.5937
二者几乎齐平,说明 MoE 在「保住激活参数预算」下未损 Omni 一致性。
5.2 消融要点
Talker hidden size 消融:降到 512 / 384,CER 急剧恶化——证明 8 码本预测不能靠缩小 Talker 省参,每个码本头都需要足够容量分辨微妙语音细节。
音色克隆(Table 3):加入说话人嵌入 + 参考码后相似度显著提升;内置 5 音色中 uncle_fu / serena 可超 0.70,eric 等因合成质量波动偏低。
跨模型对比(Table 4):对 Mini-Omni2,英文长答不如对方,但短答(≤15 词)差距不大——而参数仅对方约 1/5。
错误分布:多集中在数字朗读(如 299792458 被 ASR 转成英文全拼)与专有名词。这类「表面形式不匹配」并不代表发音本身有错。
六、能力边界与局限Honest about its ceiling
报告从头到尾极其坦诚,不回避短板。此节单列,以正视听——它不是拿来和千亿系统对标竞速的。
局限说明
语言自然度 / 长文稳定性仍不及大模型;中等长度英文回答最易翻车
视觉通路仅 64 个图像占位符,描述复杂图像时会出现物体替换 / 属性混淆
音色克隆强依赖生成音频本身是否干净;合成一旦崩了,说话人编码器也救不回
实时打断基于简单 VAD 阈值,而非真正理解重叠语音的语义
定位自陈:「小而可检查、可复现的研究/教学基线。」正因为小,每一个设计选择(中层桥接、低秩码本头、数据格式)都被暴露出来,可供分析、改进、教学。
七、上手指南Clone · Train · Play
7.1 环境与资源
# 1. 克隆
git clone --depth 1 https://github.com/jingyaogong/minimind-o
cd minimind-o
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
# 2. 下载外部模块与权重(ModelScope)
modelscope download --model gongjy/SenseVoiceSmall --local_dir ./model/SenseVoiceSmall
modelscope download --model gongjy/siglip2-base-p32-256-ve --local_dir ./model/siglip2-base-p32-256-ve
modelscope download --model gongjy/mimi --local_dir ./model/mimi
modelscope download --model gongjy/campplus --local_dir ./model/campplus
modelscope download --model gongjy/minimind-3o-pytorch llm_768.pth --local_dir ./out
7.2 训练(trainer/ 下,mini 三阶段示意)
# 阶段一:T2A 全参数 SFT(从 LLM 权重起)
CUDA_VISIBLE_DEVICES=0 torchrun --master_port 29560 --nproc_per_node 1 \
train_sft_omni.py --learning_rate 5e-4 --data_path ../dataset/sft_t2a_mini.parquet \
--epochs 1 --batch_size 40 --use_compile 1 --from_weight llm --save_weight sft_zero \
--max_seq_len 512 --use_wandb --use_moe 0
# 阶段二:Audio projector 对齐(A2A)
... --mode audio_proj --epochs 1 --batch_size 40 --use_compile 0 ...
# 阶段三:A2A 全参数微调
... --learning_rate 2e-5 --epochs 1 --batch_size 16 --max_seq_len 768 ...
7.3 推理与玩
# 命令行问答
python eval_omni.py --load_from model --weight sft_omni
# 或 Transformers 格式
python eval_omni.py --load_from minimind-3o
# WebUI:非实时 Gradio 演示
cp -r minimind-3o ./scripts/minimind-3o && cd scripts && python web_demo_omni.py
# 实时语音通话:
cd webui && python web_demo.py
7.4 硬件门槛
最低可行:单张 RTX 3090(24GB)即可训 mini + 推理;CPU 可快速推理。
作者配置:8× RTX 3090,128GB RAM,Ubuntu 20.04,CUDA 12.2,Python 3.10。
在线体验:ModelScope 在线 Demo;视频介绍 Bilibili BV1V1RsBcEMX。
八、定位判断与价值Small-but-inspectable
8.1 与级联方案、端到端大模型的对照
维度ASR+LLM+TTS 级联MiniMind-O(端到端小模型)
延迟三段串行,高文本先出、音频码延迟数帧,低延迟
语气/情绪文本中介丢失hidden state 直接连通,保留
错误归因模块割裂共享表征,易定位
复现门槛工程直但拼装单一权重闭环,全开源
模型参数输入输出开源程度训练成本
GPT-4o千亿级(未公开)文/音/图文/音闭源海量
Qwen-Omni数 B文/音/图/视频文/音权重开,数据未必全大
Moshi数 B文/音文/音(双工)部分大
Mini-Omni2约 5× MiniMind-O文/音/图文/音较开大
MiniMind-O0.1B(113M 可训练)文/音/图文/流式音代码+权重+数据全开4×3090 <4h
8.2 它真正卖的是什么
不是效果,是「可检查」。把模型缩到能看清每个零件怎么转,本身就是方法学贡献。在越来越追求参数竞赛的圈子里,这是一种清流。
教育价值:所有核心算法从零用 PyTorch 原生实现,不依赖三方框架高层抽象——可读、可改、可训,是「活体解剖级」的 Omni 教材。
研究价值:暴露出三个规模敏感设计点,可作为小模型 Omni 的基线,供分析、改进、对照。
九、参考与出处Sources
[1] Jingyao Gong. MiniMind-O Technical Report: An Open Small-Scale Speech-Native Omni Model. arXiv:2605.03937 (2026-05-05). arxiv.org/abs/2605.03937
[2] GitHub 仓库 jingyaogong/minimind-o. github.com/jingyaogong/minimind-o
[3] 官方主页 jingyaogong.github.io/minimind-o
[4] Hugging Face 集合 / ModelScope 集合(jingyaogong/minimind-o)
[5] 模型权重与数据集:ModelScope gongjy/minimind-3o-pytorch、gongjy/minimind-o_dataset
[6] 第三方逐行解读:p-chao《MiniMind-O 学习笔记 14》;今日头条《0.1B小模型实现全模态输入与流式语音输出》;zread.ai 模型权重拆解
[7] 基座项目:jingyaogong/minimind(语言)、jingyaogong/minimind-v(视觉)
说明:本文所有数值(CER 0.0897/0.0900、音色相似度 0.5995/0.5937、数据规模、训练耗时、模块参数)均引自上述技术报告、官方 README 与逐行解读;未做主观推断。报告成文由 AI 辅助研究工具整理。
深度研究 · MiniMind-O · 2026-08-26 · 费曼式文白相间 · 数据截至检索日